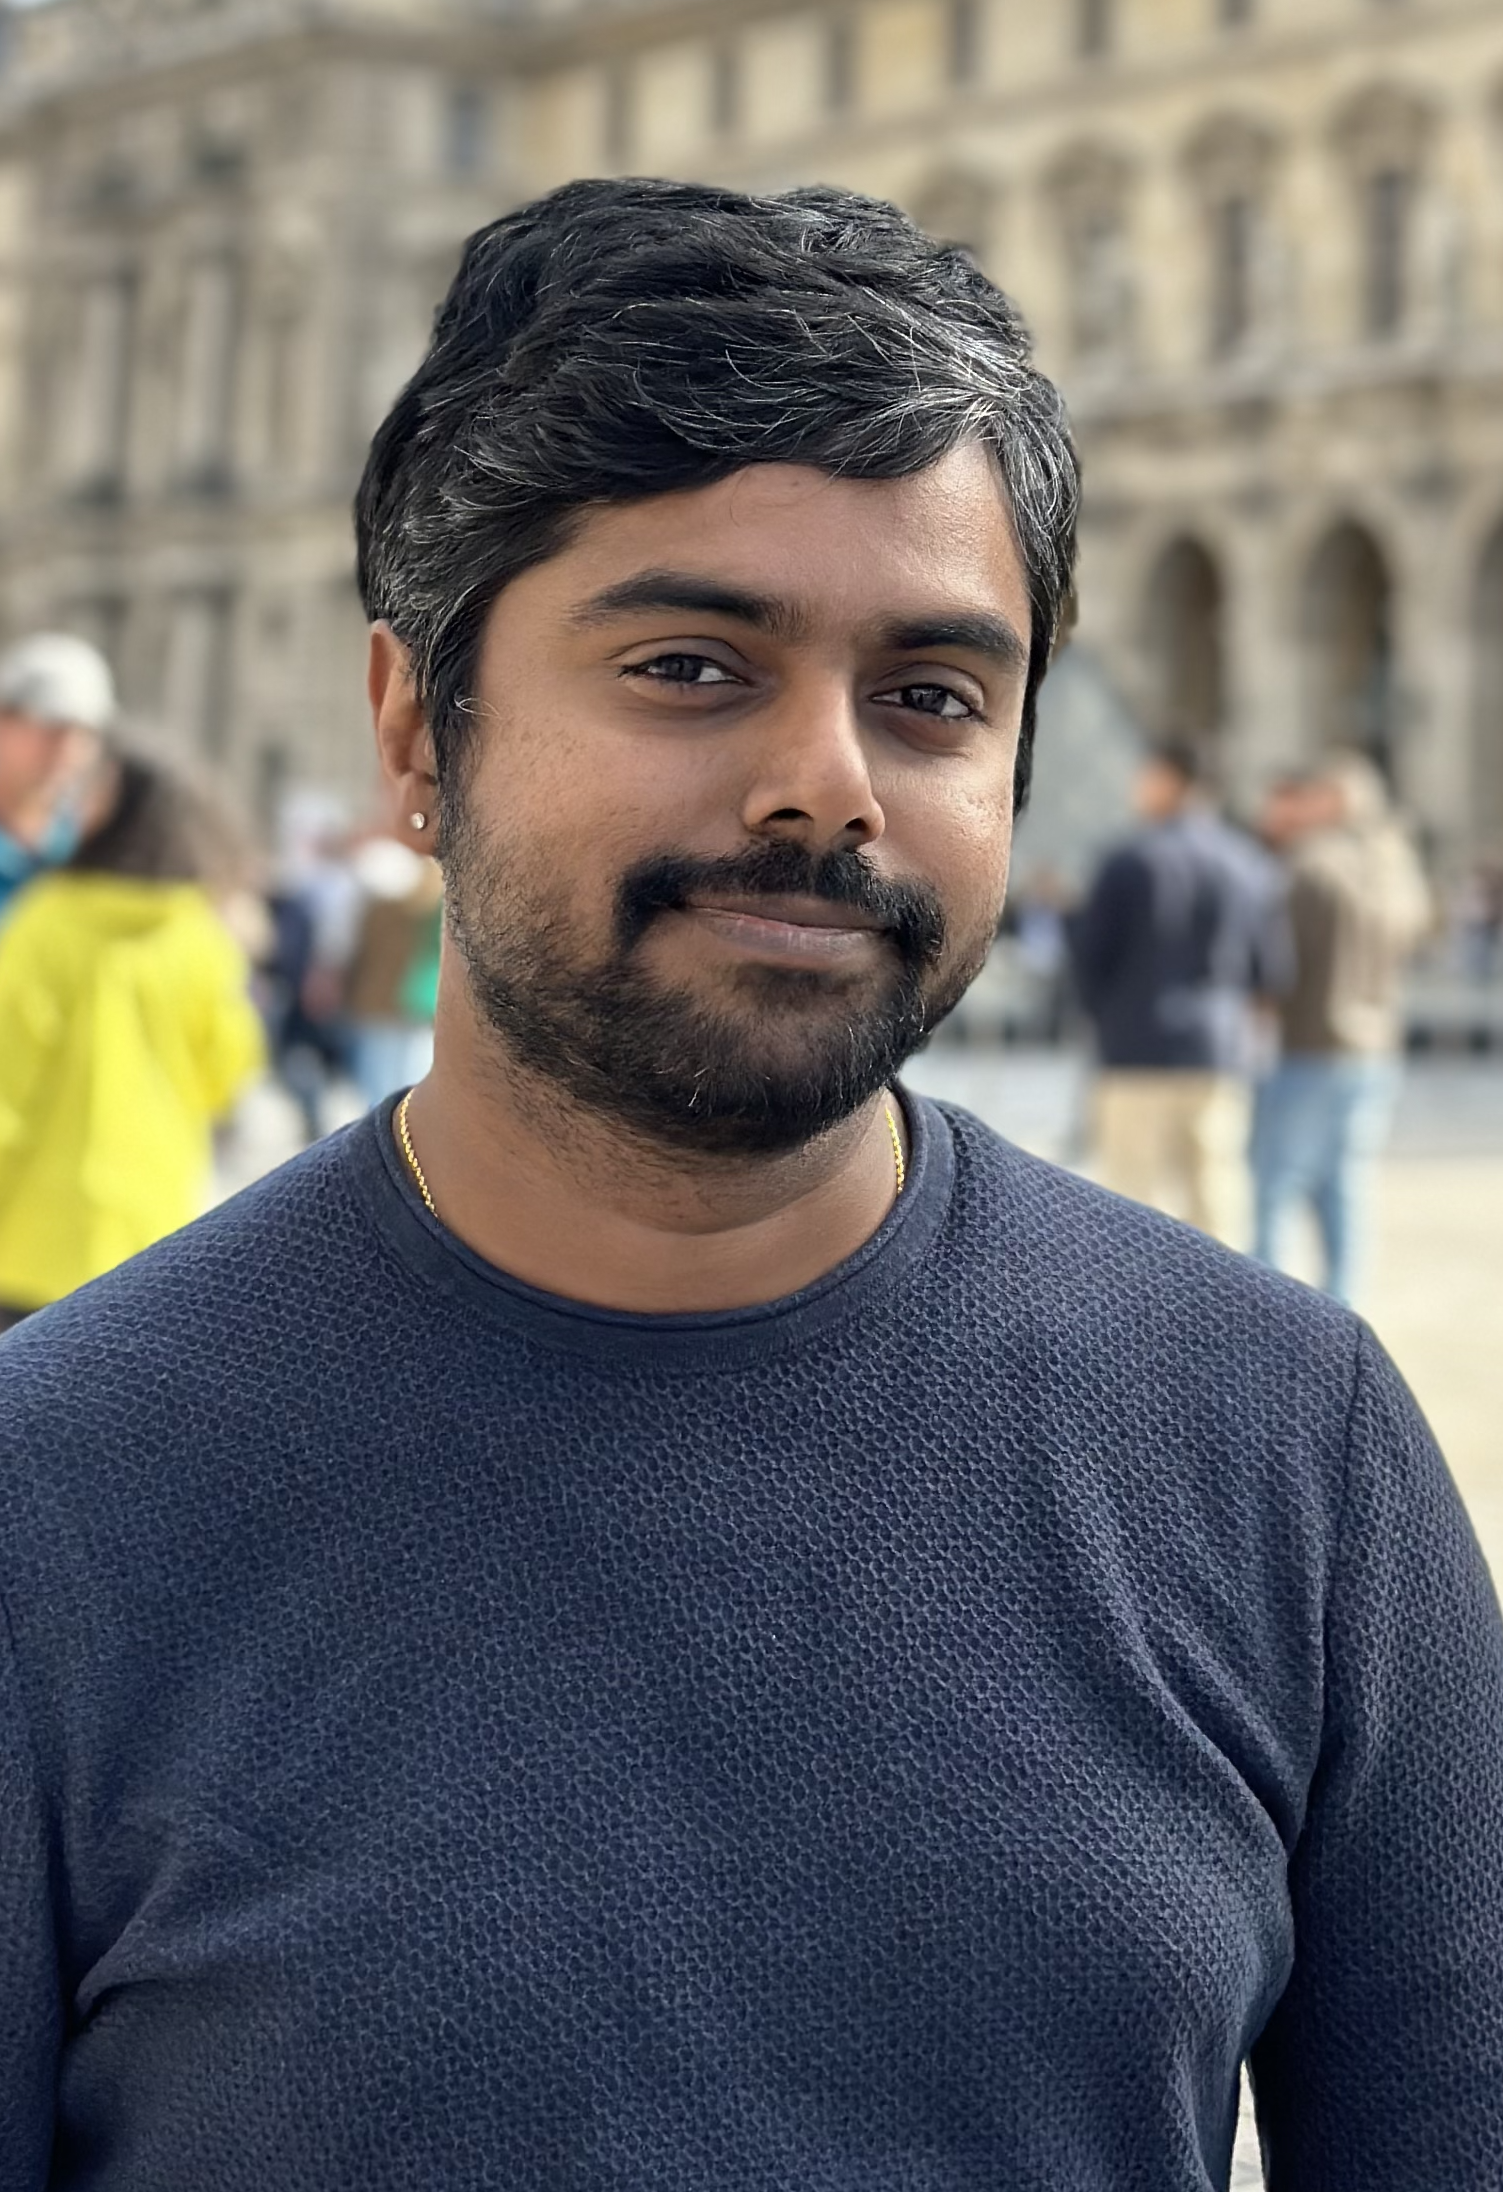
Aravind Putrevu
Devrel

Februar 26, 2024 | 12:00 - 1:00 PM (UTC) Koordinierte Weltzeit (UTC)
Sind Sie bereit für die ersten Schritte mit KI und den neuesten Technologien? Microsoft Reactor bietet Veranstaltungen, Schulungen und Communityressourcen, die Entwicklern, Unternehmern und Startups helfen, auf KI-Technologie und mehr aufzubauen. Seien Sie dabei!
Februar 26, 2024 | 12:00 - 1:00 PM (UTC) Koordinierte Weltzeit (UTC)
 Livestream
Thema: Data Science und maschinelles Lernen
Sprache: Englisch
Labeled data powers AI/ML in the enterprise, but real-world datasets have been found to contain between 7-50% annotation errors. Imperfectly labelled text data hampers ML models' training (and evaluation) across tasks like intent recognition, entity recognition, and sequence generation. Although pretrained LLMs are equipped with a lot of world knowledge, their performance is adversely affected by noisy training data (as noted by OpenAI).
In this talk, we illustrate data-centric techniques to mitigate the effect of label noise without changing any code related to model architecture, hyperparameters, or training. These data quality improvement techniques should thus remain applicable even for future advanced LLMs like GPT-10.
Referenten
Aravind Putrevu
Devrel